前篇提到了服务端 241220 的启动关联到了 mongodb,也至于我没用过这玩意,搞得我一头雾水,经过了半个月的琢磨,也算是掌握了一些基本操作,接下来我将讲解一下几点,从而让我们在使用 MongoDB 时更加得心应手。
导入
- 打开 MongoDB 的 GUI 面板,创建一个我们自己的数据库 (面板上找到并点击 localhost:27017 右面的+号),名字为 boombeach,集合名字为 pp,然后点击 create database 即完成创建
- 看似空空如也,我们现在开始导入玩家数据 (海岛服务端中的 pp 文件夹内的 json 数据文件),先选中集合 pp 文件夹,然后点击 add data,然后点击 import json or csv file,然后导入 0.json
- 打开海岛奇兵服务端 (确保不闪退,可以正常运行,如果闪退那就是 0.json 你没搞好,我在上一篇搭建 241220 服务端中提到过,你需要删除一些段落并将 {} 替换为 []),然后打开 GUI 面板,删除所有玩家数据,点垃圾桶图标即可
- 在海岛服务端面板中输入 (不能有玩家在线)
/mongoimportpp等待一会后便导入完成,你会在 mongodb 面板中的 pp 文件夹内看到所有玩家数据了
导出
- 安装 python
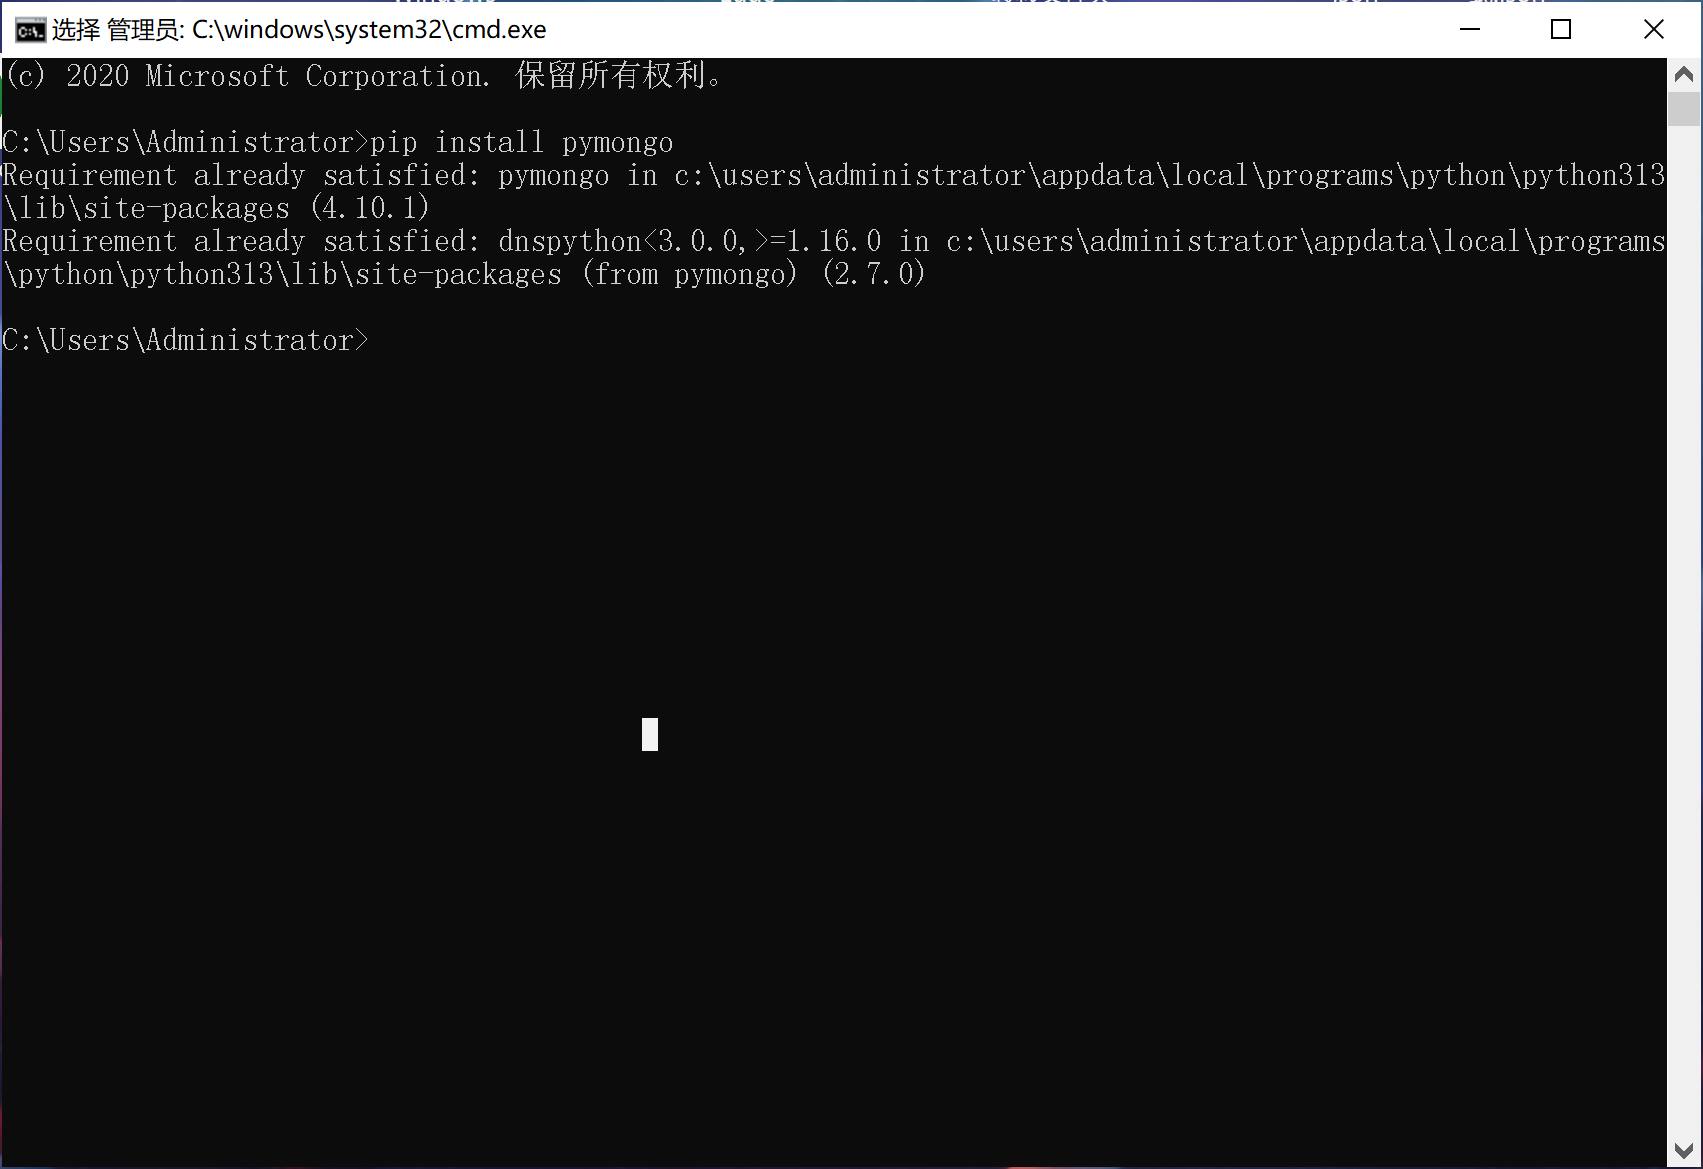
- 打开 cmd 终端命令窗口,输入以下代码,目的是下载一个数据库
pip install pymongo如果出现以下内容,那么则代表下载完毕
- 之后创建一个 py 文件,直接创建一个 txt 文本文件改后缀即可
此 py 文件内容如下:
import sys
from pymongo import MongoClient
import json
import os

# 核心配置 (只留必要项)
SAVE_DIR = "D:/MongoDB 数据库玩家 json 文件夹"
COLLECTIONS = ["pp", "level"]  # 要导出的集合
# 优先用数据里的唯一字段当文件名 (按实际字段调整,没有则用索引)
FILE_NAME_FIELD = ["player_id", "id", "user_id"]  # 顺序:先找 player_id,再找 id...

def get_filename(data, index):
    """获取文件名:优先用数据里的唯一字段,没有则用索引"""
    for field in FILE_NAME_FIELD:
        if field in data:
            return f"{data[field]}.json"  # 用唯一字段当文件名 (如 12345.json)
    return f"{index}.json"  # 无唯一字段时用索引命名

def main():
    # 询问确认
    print(f"导出路径:{SAVE_DIR}(不存在会自动创建)")
    if input("是否继续?(y=是,其他=否):").strip().lower() != "y":
        print("程序退出")
        return

    # 连接数据库
    try:
        client = MongoClient('mongodb://localhost:27017/')
        db = client.boombeach
        print("MongoDB 连接成功")
    except Exception as e:
        print(f"数据库连接失败:{e}")
        return

    # 创建文件夹
    try:
        for coll in COLLECTIONS:
            coll_dir = os.path.join(SAVE_DIR, coll)
            if not os.path.exists(coll_dir):
                os.makedirs(coll_dir)
        print("文件夹创建完成")
    except Exception as e:
        print(f"文件夹创建失败:{e}")
        return

    # 导出数据 (不修改原始数据,只删_id)
    for coll in COLLECTIONS:
        print(f"\n 开始导出 {coll} 集合...")
        collection = db[coll]
        total = collection.count_documents({})
        print(f"共 {total} 条数据")

        if total == 0:
            print(f"{coll} 集合无数据,跳过")
            continue

        success = 0
        for idx, data in enumerate(collection.find()):
            try:
                data.pop('_id', None)  # 只移除数据库自动生成的字段,不碰原始数据
                filename = get_filename(data, idx)
                file_path = os.path.join(SAVE_DIR, coll, filename)
                # 保存原始数据 (不修改任何字段和值)
                with open(file_path, 'w', encoding='utf-8') as f:
                    json.dump(data, f, indent=2, ensure_ascii=False, default=str)
                success += 1
            except Exception as e:
                print(f"第 {idx} 条数据失败:{e}")

        print(f"{coll} 导出完成:成功 {success} 条,失败 {total-success} 条")

    print(f"\n 所有导出完成,文件路径:{SAVE_DIR}")
    input("按回车关闭...")

if __name__ == "__main__":
    main()
我这里将导出路径设置为了 MongoDB 数据库玩家 json 文件夹的文件名,你只需要去 D 盘根目录创建一个 「MongoDB 数据库玩家 json 文件夹」 的文件名即可,执行 py 后这个文件夹内自然会出现带有序号的 json 玩家数据,这些数据都应该存放在服务器的 pp 文件夹中,每一个序号代表一个玩家。
第二个是单独导出 (选项性,既可以单独也可以一键导出):
import sys
from pymongo import MongoClient
import json
import os

# 核心配置
SAVE_DIR = "MongoDB 数据库玩家 json 文件夹"
PP_COLLECTION = "pp"          # pp 集合名称
LEVEL_COLLECTION = "level"    # level 集合名称
PP_MATCH_FIELD = "PlayerID"   # pp 集合查询字段 (PlayerID)
LEVEL_MATCH_FIELDS = ["player_id", "id", "user_id", "home_id"]  # level 集合与 PlayerID 匹配的字段 (顺序匹配)

def get_filename(data, coll_name, index=0):
    """生成文件名:优先用匹配字段,无则用索引"""
    if coll_name == PP_COLLECTION and PP_MATCH_FIELD in data:
        return f"{data[PP_MATCH_FIELD]}.json"
    elif coll_name == LEVEL_COLLECTION:
        for field in LEVEL_MATCH_FIELDS:
            if field in data:
                return f"{data[field]}.json"
    return f"数据_{index}.json"

def export_specific_player(player_id):
    """单独导出指定 PlayerID 的 pp 和 level 数据 (无则忽略)"""
    print(f"\n🔍 正在查询 PlayerID = {player_id} 的关联数据...")

    # 连接数据库
    try:
        client = MongoClient('mongodb://localhost:27017/')
        db = client.boombeach
        print("✅ MongoDB 连接成功!")
    except Exception as e:
        print(f"❌ 数据库连接失败:{e}")
        return

    # 创建存储文件夹 (确保目录存在)
    pp_dir = os.path.join(SAVE_DIR, PP_COLLECTION)
    level_dir = os.path.join(SAVE_DIR, LEVEL_COLLECTION)
    for dir_path in [pp_dir, level_dir]:
        if not os.path.exists(dir_path):
            os.makedirs(dir_path)

    # 1. 导出 pp 集合数据
    print("\n" + "-" * 50)
    print(f"📤 导出 {PP_COLLECTION} 集合数据...")
    pp_coll = db[PP_COLLECTION]
    pp_query = {PP_MATCH_FIELD: player_id}
    pp_data_list = list(pp_coll.find(pp_query))

    if pp_data_list:
        print(f"✅ 找到 {len(pp_data_list)} 条 pp 数据")
        for idx, data in enumerate(pp_data_list):
            data.pop('_id', None)  # 移除数据库自动字段
            filename = get_filename(data, PP_COLLECTION, idx)
            file_path = os.path.join(pp_dir, filename)
            with open(file_path, 'w', encoding='utf-8') as f:
                json.dump(data, f, indent=2, ensure_ascii=False, default=str)
            print(f"   ✅ 已保存:{file_path}")
    else:
        print(f"ℹ️  未找到 {PP_COLLECTION} 集合中 PlayerID = {player_id} 的数据 (已忽略)")

    # 2. 导出 level 集合关联数据 (匹配任意字段,无则忽略)
    print("\n" + "-" * 50)
    print(f"📤 导出 {LEVEL_COLLECTION} 集合关联数据...")
    level_coll = db[LEVEL_COLLECTION]
    level_data_list = []
    matched_field = None

    # 按顺序匹配 level 集合的字段
    for field in LEVEL_MATCH_FIELDS:
        level_query = {field: player_id}
        temp_data = list(level_coll.find(level_query))
        if temp_data:
            level_data_list = temp_data
            matched_field = field
            break

    if level_data_list:
        print(f"✅ 找到 {len(level_data_list)} 条 level 数据 (匹配字段:{matched_field})")
        for idx, data in enumerate(level_data_list):
            data.pop('_id', None)  # 移除数据库自动字段
            filename = get_filename(data, LEVEL_COLLECTION, idx)
            file_path = os.path.join(level_dir, filename)
            with open(file_path, 'w', encoding='utf-8') as f:
                json.dump(data, f, indent=2, ensure_ascii=False, default=str)
            print(f"   ✅ 已保存:{file_path}")
    else:
        print(f"ℹ️  未找到 {LEVEL_COLLECTION} 集合中与 PlayerID = {player_id} 匹配的数据 (已忽略)")

    print("\n" + "=" * 50)
    print("🎉 指定玩家数据导出完成!")
    print(f"📁 文件存储根路径:{os.path.abspath(SAVE_DIR)}")
    print("=" * 50)

def batch_export_all():
    """全部导出 pp 和 level 集合所有数据"""
    print(f"\n📂 导出根路径:{os.path.abspath(SAVE_DIR)}")
    print(f"📊 待导出集合:{PP_COLLECTION} 、 {LEVEL_COLLECTION}")
    print("=" * 50)
    if input("是否开始全部导出?(y=是,其他=否):").strip().lower() != "y":
        print("🚫 程序退出")
        return

    # 连接数据库
    try:
        client = MongoClient('mongodb://localhost:27017/')
        db = client.boombeach
        print("✅ MongoDB 连接成功!")
    except Exception as e:
        print(f"❌ 数据库连接失败:{e}")
        return

    # 创建文件夹
    for coll in [PP_COLLECTION, LEVEL_COLLECTION]:
        coll_dir = os.path.join(SAVE_DIR, coll)
        if not os.path.exists(coll_dir):
            os.makedirs(coll_dir)
            print(f"✅ 已创建文件夹:{coll_dir}")

    # 批量导出每个集合
    for coll_name in [PP_COLLECTION, LEVEL_COLLECTION]:
        print("\n" + "=" * 60)
        print(f"📤 开始导出 [{coll_name}] 集合所有数据...")
        print("=" * 60)
        collection = db[coll_name]
        total = collection.count_documents({})
        print(f"ℹ️  [{coll_name}] 集合共查询到 {total} 条数据")

        if total == 0:
            print(f"ℹ️  [{coll_name}] 集合无数据,跳过导出")
            continue

        success = 0
        used_filenames = set()
        for idx, data in enumerate(collection.find()):
            try:
                data.pop('_id', None)
                filename = get_filename(data, coll_name, idx)
                # 处理文件名冲突
                while filename in used_filenames:
                    filename = f"{filename[:-5]}_重复 {len(used_filenames)}.json"
                used_filenames.add(filename)
                # 保存文件
                file_path = os.path.join(SAVE_DIR, coll_name, filename)
                with open(file_path, 'w', encoding='utf-8') as f:
                    json.dump(data, f, indent=2, ensure_ascii=False, default=str)
                success += 1
                if idx % 10 == 0:  # 每 10 条输出一次进度 (避免刷屏)
                    print(f"ℹ️  已导出 {success}/{total} 条数据")
            except Exception as e:
                print(f"❌ 第 {idx+1} 条数据导出失败:{str(e)[:50]}...")

        print(f"\n📊 [{coll_name}] 集合导出统计:")
        print(f"   总数据量:{total} 条")
        print(f"   成功导出:{success} 条")
        print("-" * 60)

    print("\n" + "=" * 60)
    print("🎉 全部数据导出完成!")
    print(f"📁 最终文件路径:{os.path.abspath(SAVE_DIR)}")
    print("=" * 60)

def main():
    # 程序入口:简洁选项
    print("=" * 60)
    print("          MongoDB 数据导出工具")
    print("=" * 60)
    print("📌 导出选项:")
    print("   1 - 单独导出指定玩家的数据")
    print("   2 - 全部导出 (pp + level 所有数据)")
    print("=" * 60)

    # 选择功能 (容错处理)
    while True:
        choice = input("请输入选择 (1 或 2):").strip()
        if choice in ["1", "2"]:
            break
        print("❌ 输入无效!请仅输入 1 或 2")

    if choice == "1":
        # 单独导出:询问 PlayerID
        while True:
            player_id_input = input("\n 请输出该玩家的 PlayerID:").strip()
            if player_id_input:
                # 兼容数字/字符串类型的 PlayerID
                try:
                    player_id = int(player_id_input)
                except ValueError:
                    player_id = player_id_input
                break
            print("❌ PlayerID 不能为空,请重新输入!")
        export_specific_player(player_id)
    else:
        batch_export_all()

    # 防止程序闪退
    input("\n 按回车关闭程序...")

if __name__ == "__main__":
    main()
搜索
以 {"PlayerID": 12} 为例子
playerid 就是大类,而 12 是这一类其中一个 json 数据的一个数值,其他搜索方法也是如此
如果我们需要查找玩家名字,通过名字来找到对方 ID 并实时操作
{"PlayerName": "哈哈"}
{"playername": "BOSS"}